Siluetteihin perustuva parametrinen 3D-mallinnus agenttien avulla
Uusimmat tekoälymallit ovat jo todella hyviä 3D-mallinnuksessa. Ne osaavat mallintaa esineen pelkkien kuvien perusteella. Oikealla prosessilla ne voivat luoda parametrisen mallin ja saada mitat kohdalleen pelkästään yhden esineestä mitatun mitan avulla. Uusimmat tekoälymallit ja siluetteihin perustuva mallinnusprosessi tekee tämän mahdolliseksi käytännössä.
Aiemmassa artikkelissa kerroin ompelukoneen moottorin moottorin mallintamisesta 20 kuvan avulla. Mallinnus käytti agenteille suunniteltua työnkulkua, joka ammentaa inspiraatiota structure-from-motion-menetelmästä [1]1. J. Alatalo. Creating a parametric 3D model of a sewing machine motor from 20 images using GPT6-Astra. Jamk Arena Pro. 2026. https://urn.fi/urn:nbn:fi:jamk-issn-2984-0783-364. Menetelmä toimi todella hyvin! Interaktiivinen demo löytyy täältä: https://janne-alatalo.github.io/agentic-structure-from-motion Menetelmä toimii niin, että agentti tunnistaa kuvista piirteitä ja yhdistelee niitä kuvien välillä. Agentti käyttää tunnistettuja piirteitä 3D-mallin rakentamiseen sekä kameroiden sijainnin ja linssin projektioparametrien arviointiin.
Vaikka tulokset olivat todella hyviä, niin työnkulussa oli vielä parannusvaraa. Se ei ole kovin tehokas ja vaatii edelleen melko paljon kuvia, vaikka se onkin selvä parannus perinteiseen structure-from-motion-menetelmään verrattuna.
Tuon projektin aikana kokeilin nopeasti, että voisiko siluetteihin perustuvaa optimointia käyttää kameroiden sijaintejen ja suunnan arviointiin sekä moottorin mallintamiseen. Tulokset olivat todella lupaavia. Näytti siltä, että siluetteihin perustuva menetelmä olisi tehokkaampi ja se toimisi vähemmällä kuvamäärällä.
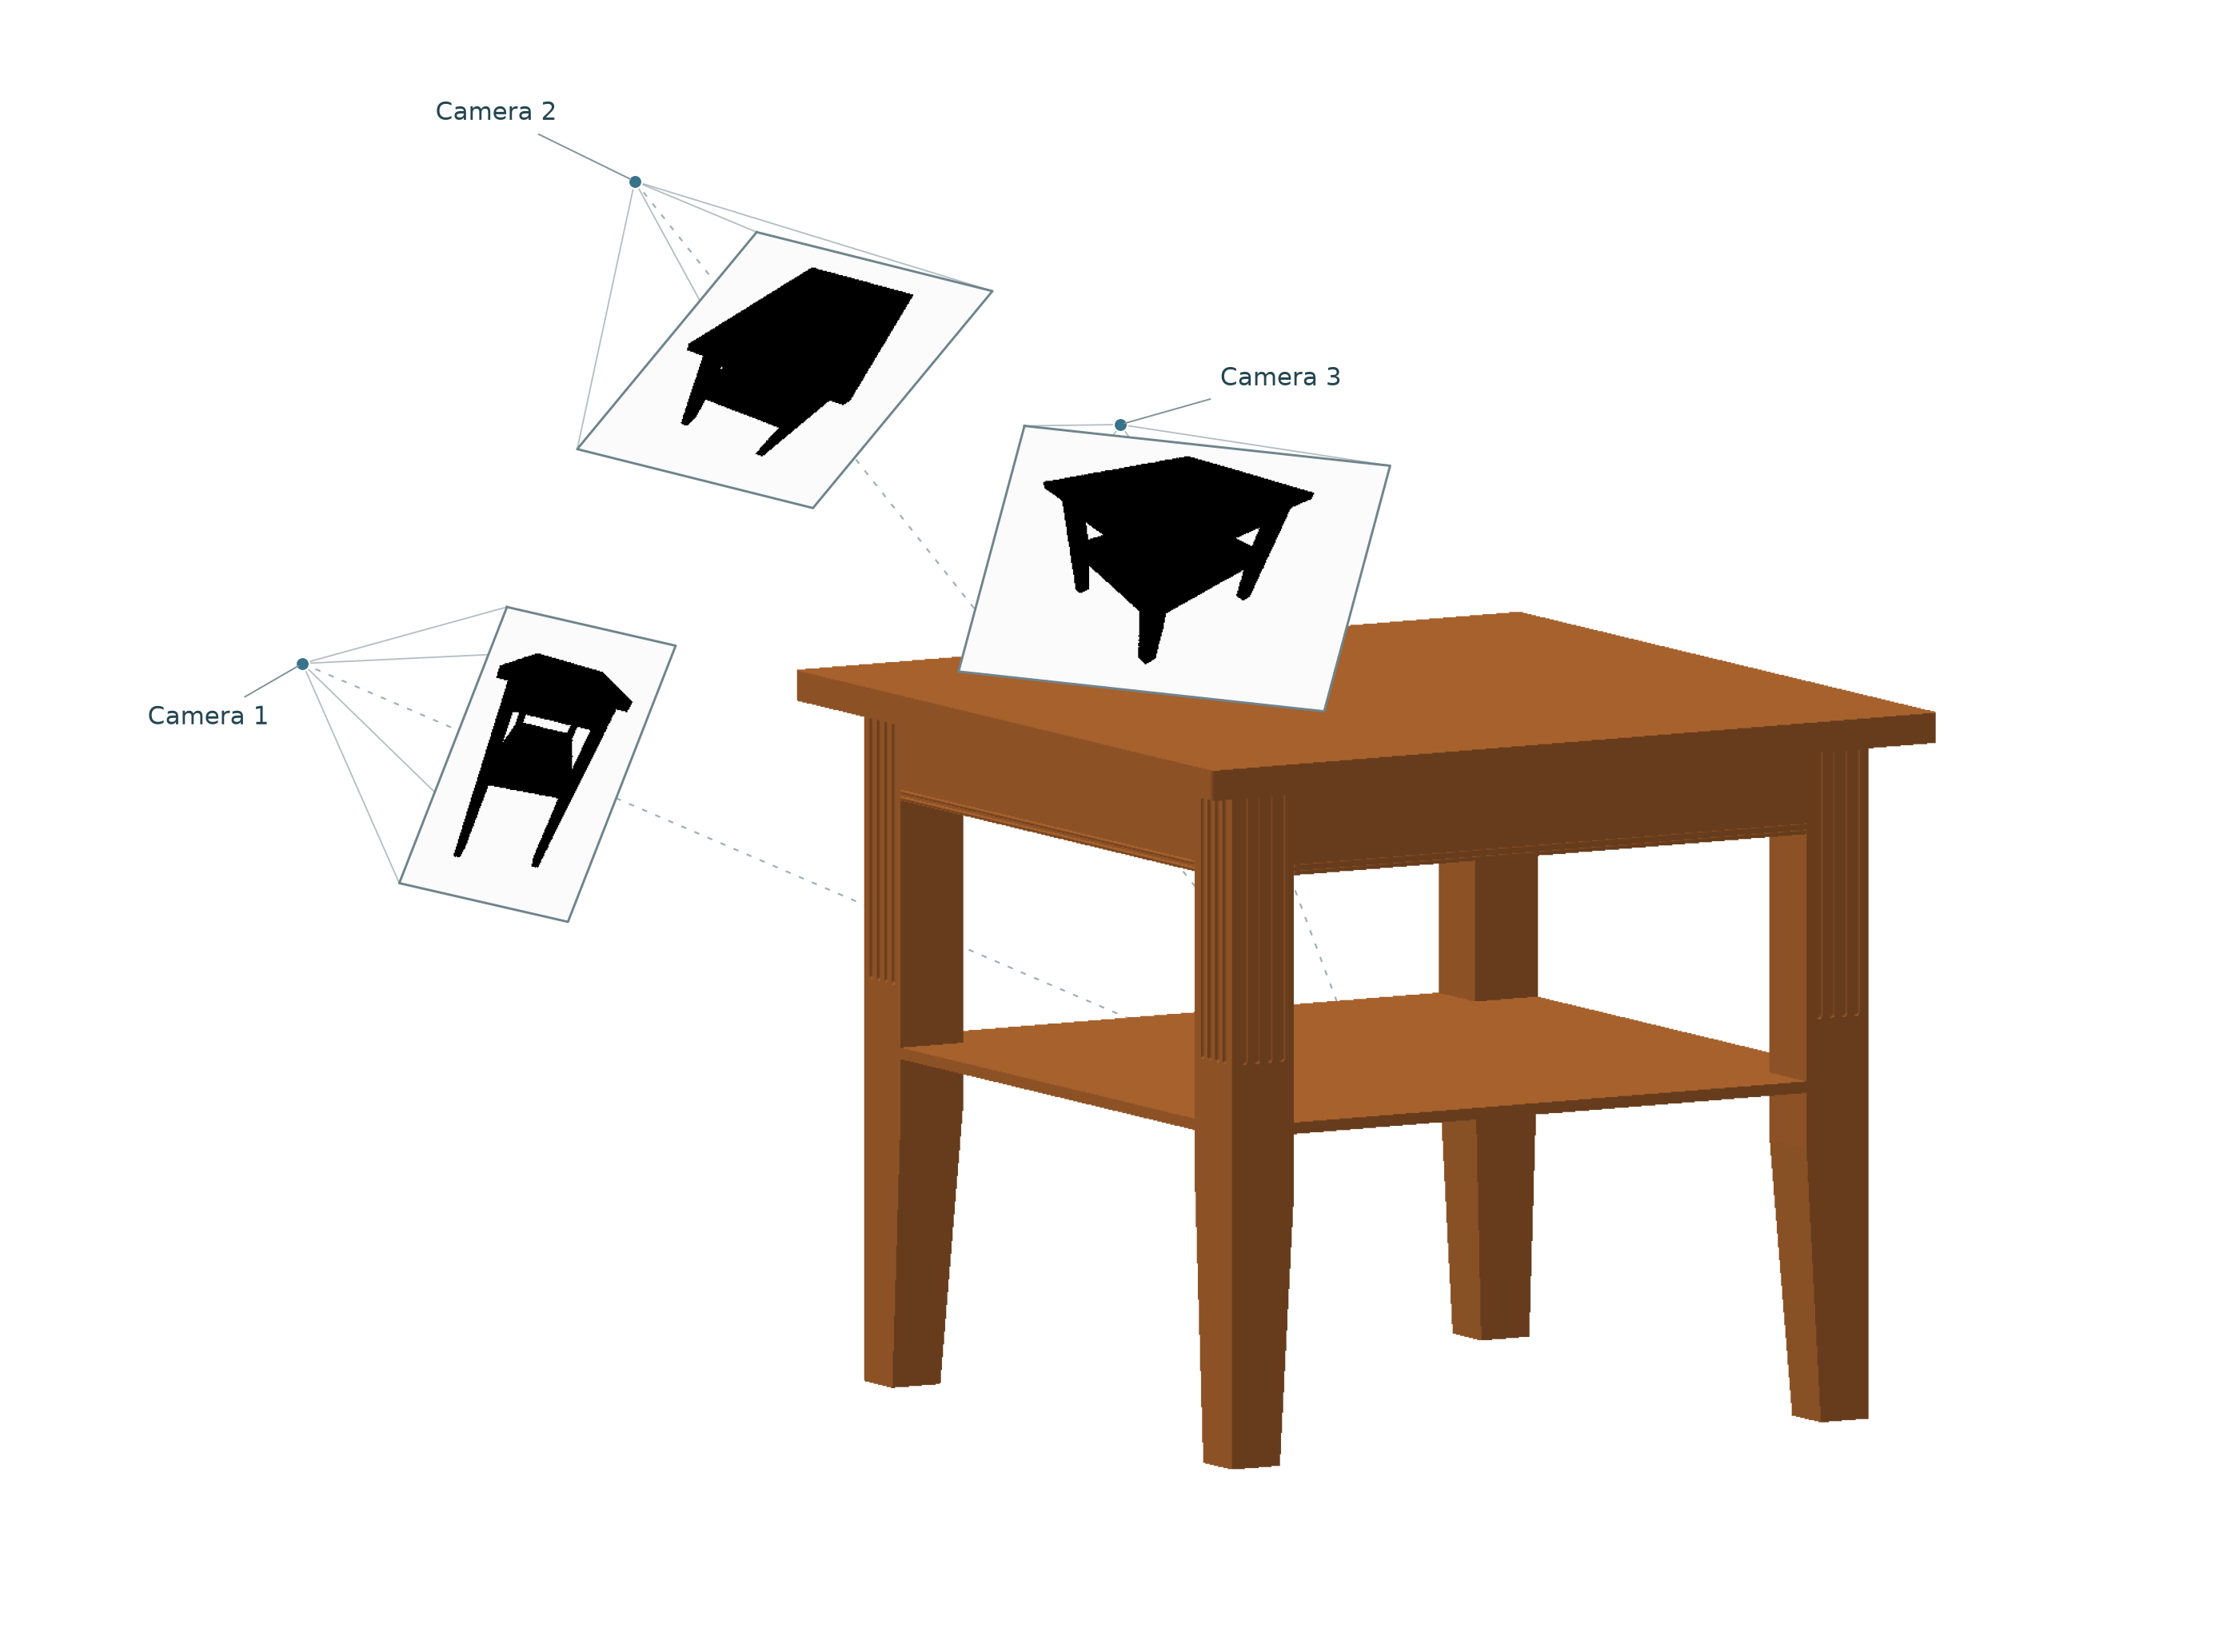
Siluetteihin perustuvassa menetelmässä 3D-malli sekä kameroiden sijainnit ja suunnat arvioidaan kuvista segmentoitujen siluettien avulla. Siluetti on 2D-tasolle projisoidun 3D-kohteen varjokuva. Kuva 1 havainnollistaa ajatusta. Eri 2D-tasot esittävät näkymiä eri kamerakulmista.
Ajatus siluettien käyttämisestä mallinnuksessa ei ole uusi. Siluetteja käytetään jo kameroiden sijaintien ja suuntien arviointiin [2]2. Z. Wu, W. Jiang, and H. Yu. Analytical derivatives for differentiable renderer: 3D pose estimation by silhouette consistency. Journal of Visual Communication and Image Representation. 2020. vol. 73, pp. 102960. https://doi.org/10.1016/j.jvcir.2020.102960 sekä 3D-polygoniverkkojen optimointiin [3]3. M. Worchel, R. Diaz, W. Hu, O. Schreer, I. Feldmann, and P. Eisert. Multi-View Mesh Reconstruction With Neural Deferred Shading. Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR). 2022. pp. 6187–6197. https://openaccess.thecvf.com/content/CVPR2022/html/Worchel_Multi-View_Mesh_Reconstruction_With_Neural_Deferred_Shading_CVPR_2022_paper.html. En ole kuitenkaan nähnyt muiden käyttävän menetelmää modernien tekoälymallejen ja agenttien kanssa.
Nykyaikaiset tekoälyagentit mahdollistavat paremman siluetteihin perustuvan 3D-mallinnusprosessin. Agentit voivat luoda kuvissa näkyvästä esineestä säädettävän parametrisen mallin ja etsiä optimointialgoritmien avulla parhaat parametriarvot mallin säädettäville ominaisuuksille. Tämä yksinkertaistaa optimointiongelmaa verrattuna polygoniverkkoon perustuvaan mallinnukseen, koska optimointialgoritmille tuodaan huomattavasti vähemmän parametreja optimoitavaksi. Jotta menetelmä toimii, vaaditaan kuitenkin tarpeeksi älykäs tekoälymalli tuottamaan alustava parametrinen 3D-malli, joka kuvaa kuvassa näkyvää esinettä tarpeeksi hyvin. Onneksi uusimmilla tekoälymalleilla on erittäin hyvä tietämys miten todellinen maailma toimii ja hyvä avaruudellinen hahmottaminen, joten ne pystyvät tekemään jo ensimmäisestä 3D-mallista riittävän hyvän, niin että 3D-mallin parametrien optimointi saadaan käyntiin.
Siluettien segmentointi kuvista kuvamallien avulla
Kun työstin tuota edellistä artikkelia, niin kokeilin Metan SAM 3 -mallia esineiden siluettien segmentointiin kuvista [4]4. N. Carion, L. Gustafson, Y.-T. Hu, S. Debnath, R. Hu, D. Suris, C. Ryali, K. V. Alwala, H. Khedr, A. Huang, J. Lei, T. Ma, B. Guo, A. Kalla, M. Marks, J. Greer, M. Wang, P. Sun, R. Rädle, T. Afouras, E. Mavroudi, K. Xu, T.-H. Wu, Y. Zhou, L. Momeni, R. Hazra, S. Ding, S. Vaze, F. Porcher, F. Li, S. Li, A. Kamath, H. K. Cheng, P. Dollár, N. Ravi, K. Saenko, P. Zhang, and C. Feichtenhofer. SAM 3: Segment Anything with Concepts. 2025. https://doi.org/10.48550/arXiv.2511.16719. Harmittavasti tuo malli on todella tyhmä. Se ei esimerkiksi ymmärtänyt, mikä hihnapyörä on. Kehote ”large disk” (”suuri kiekko”) toimi ompelukoneen moottorin hihnapyörän segmentoinnissa, mutta se on huono kikka kiertää tuo rajoite. Mallia oli mahdotonta saada segmentoimaan tarkempia yksityiskohtia kuvista.
Sain segmentoinnin toimimaan tuon kikan avulla niin, että pystyin testaamaan tuota siluetteihin perustuvaa mallinnusta. Testin perusteella näin, että tuo menetelmä kyllä toimii ja olin melko varma, että jos segmentointi toimisi paremmin, niin tuo koko prosessi toimisi erittäin hyvin. Valitettavasti SAM 3 -mallin segmentointitarkkuus oli liian huono tukemaan tuota menetelmää.
Ajatus segmentointiin perustuvasta 3D-mallinnuksesta jäi takaraivoon. Luin Qwen-Image 2.1 -mallin julkaisusta kertovan blogikirjoituksen, ja sen kuvankäsittelykyky yllätti minut [5]5. Qwen Team. Qwen-Image 2.1. 2026. https://qwen.ai/blog?id=qwen-image-2.1. Tuo julkaisusta kertova blogikirjoitus muistutti minua myös Pedicinin hienosta demosta [6]6. S. Pedicini. GenAI image editing showdown. 2025. https://genai-showdown.specr.net/image-editing, joka havainnollistaa kuvamallien kykyä muokata kuvaa niin, että sen muut osat säilyvät täsmälleen ennallaan.
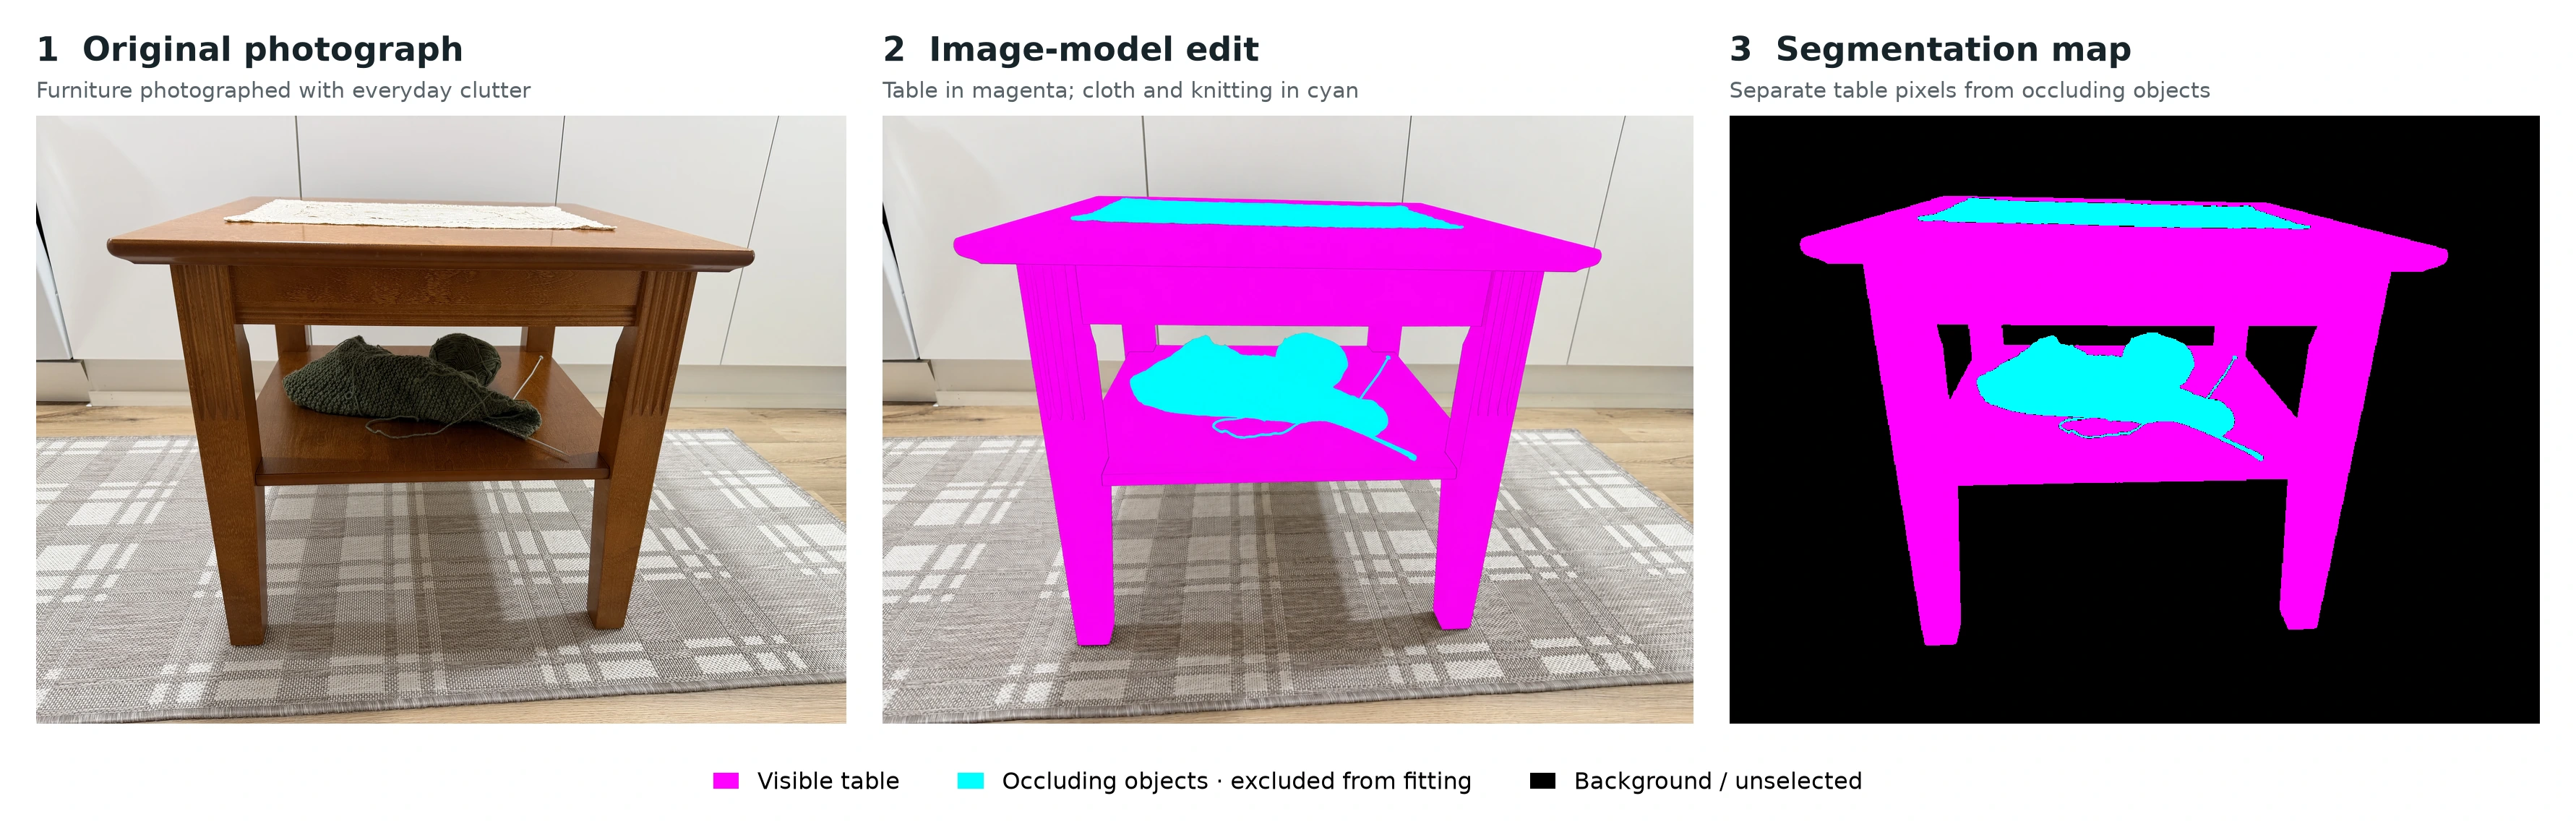
Keksin, että tätä ominaisuutta voisi käyttää segmentointiin. Kuvamallia ohjeistetaan muuttamaan vain osaa kuvasta. Esimerkiksi: ”Korosta tämän kuvan sohvapöytä magentalla ja väritä ylimääräiset tavarat syaanilla.” Muokkauksen jälkeen alkuperäisestä ja muokatusta kuvasta lasketaan erotuskuva. Tulosta voidaan käyttää segmentointiin. Kuva 2 havainnollistaa prosessia OpenAI:n ChatGPT Images 2.5 -mallilla [7]7. OpenAI. Introducing ChatGPT Images 2.5. 2026. https://openai.com/index/introducing-chatgpt-images-2-5/.
Kuvassa 3 segmentoinnin ääriviivat on piirretty alkuperäisen kuvan päälle. Tuloksena on todella tarkka pöydän segmentointi.
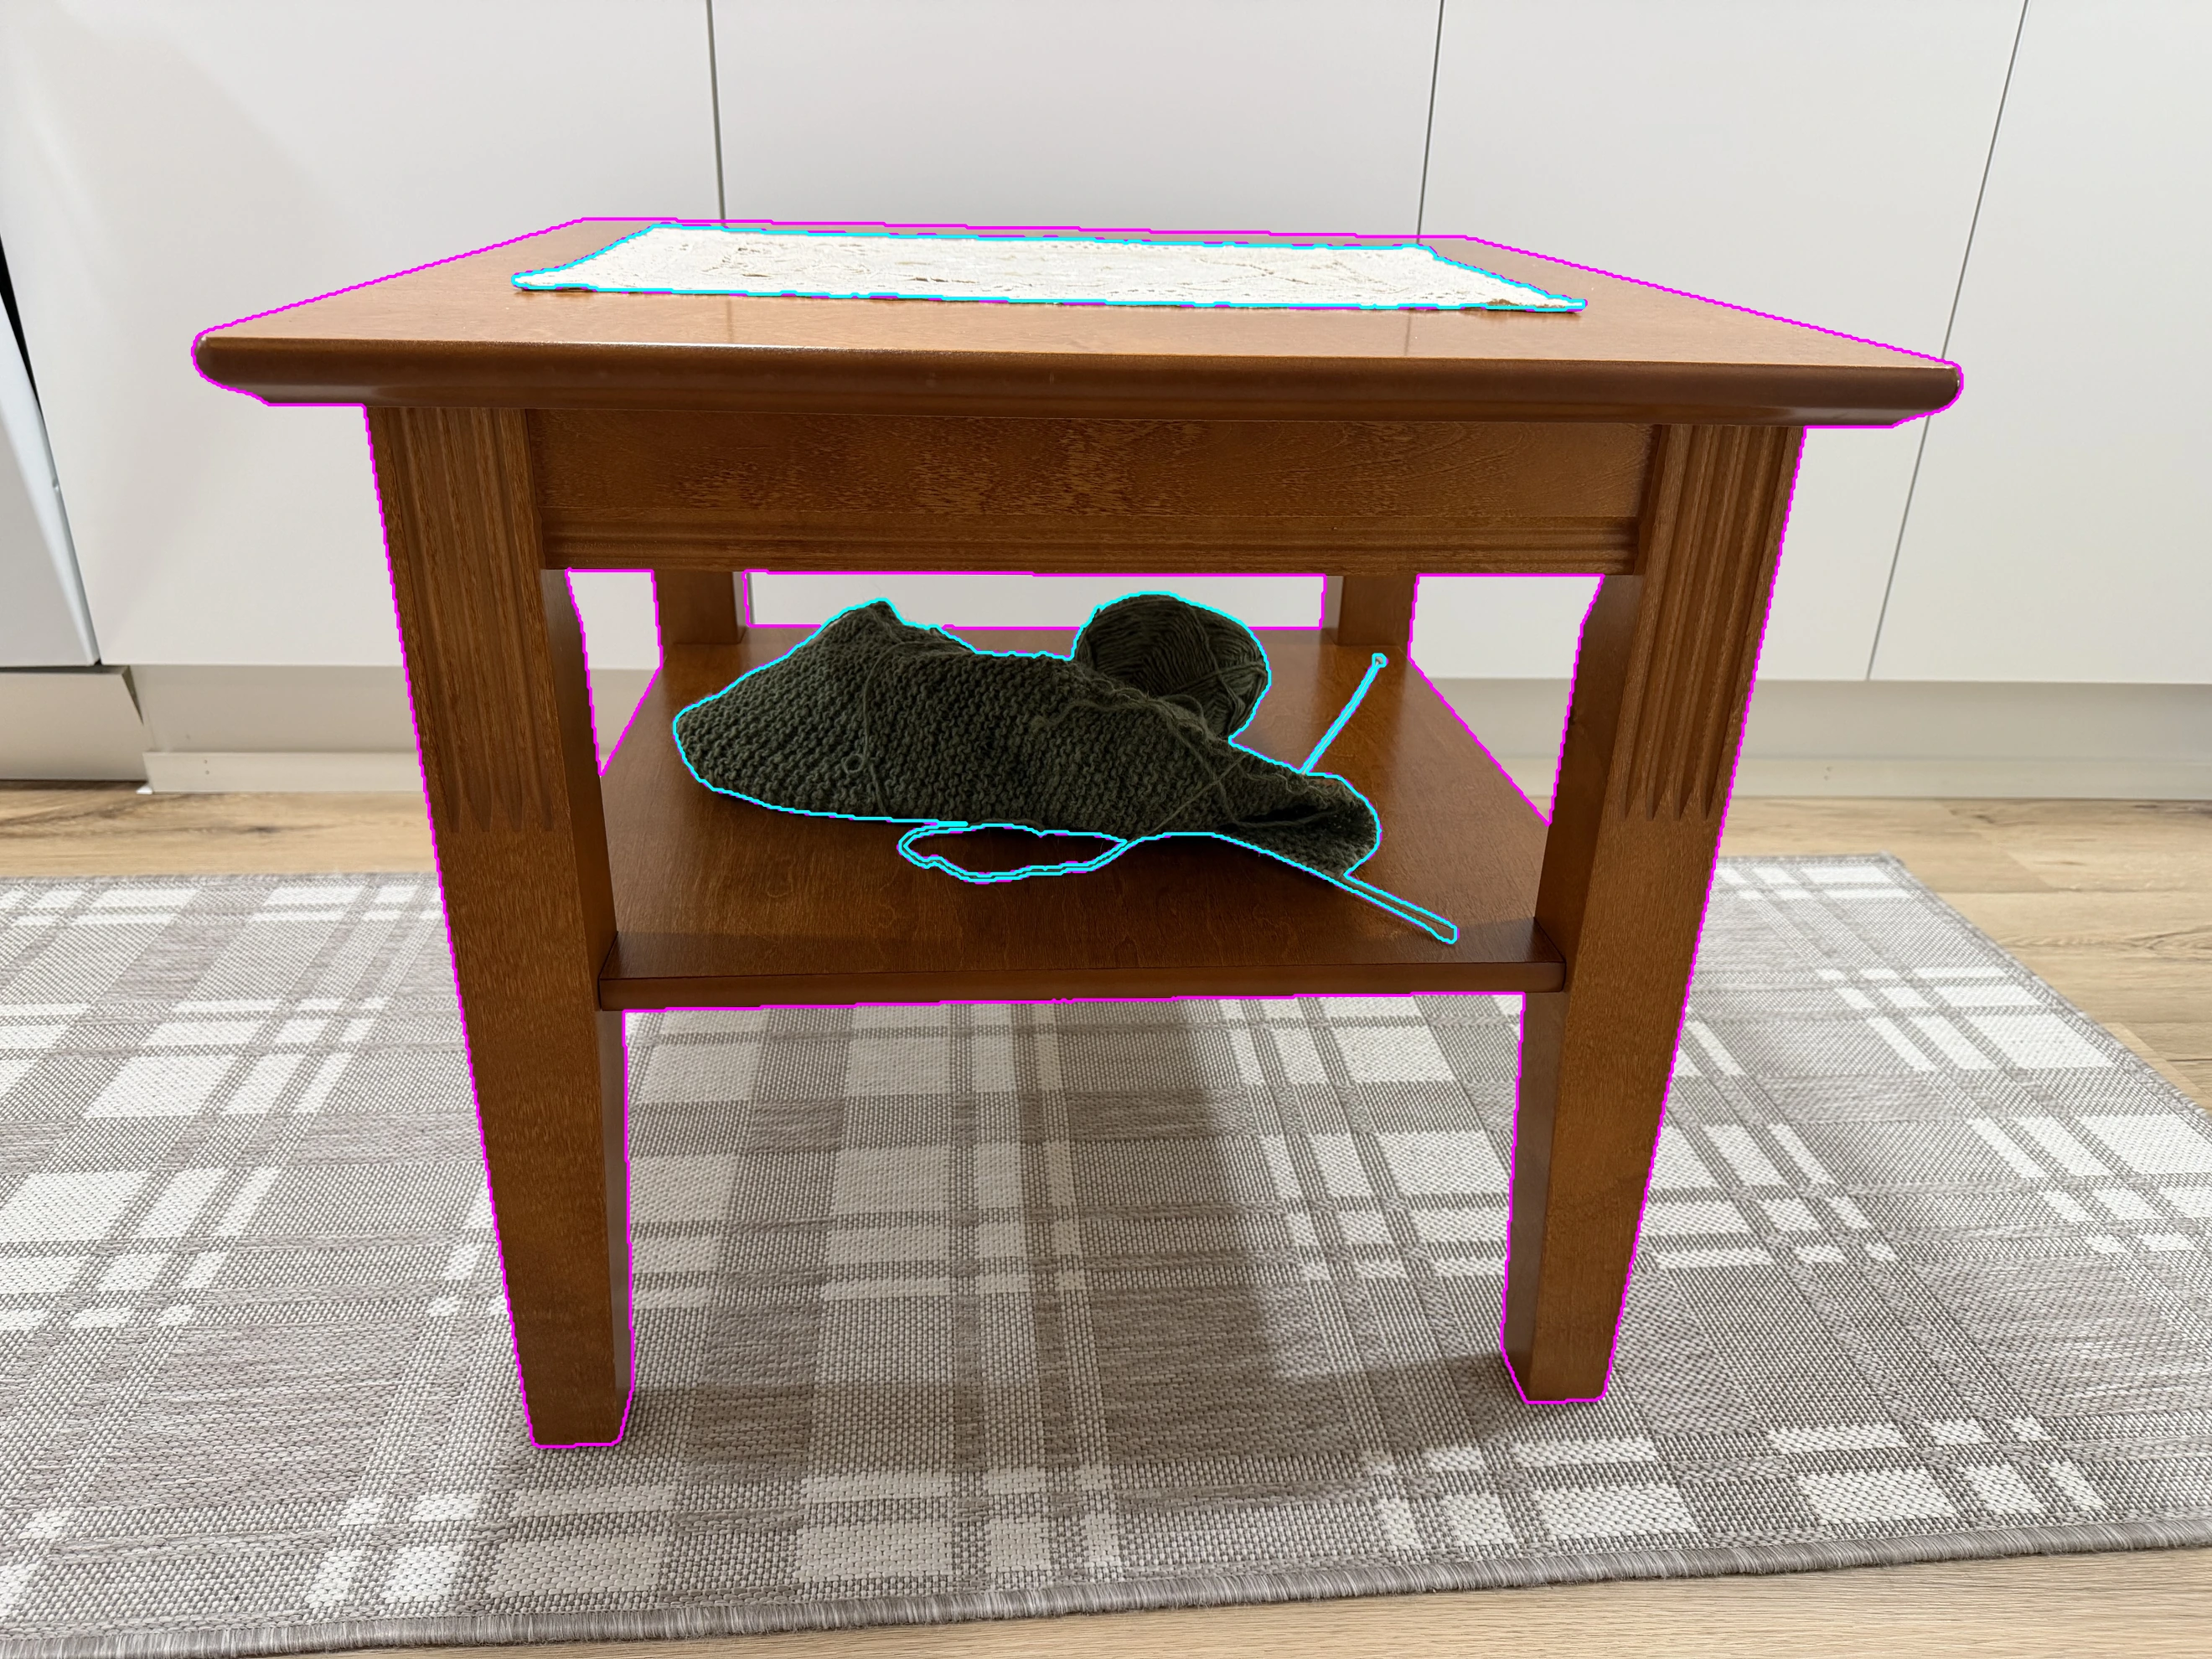
Sen lisäksi, että nämä erittäin tarkkoja, niin nämä nykyaikaiset kuvamallit ovat, ovat myös hyvin älykkäitä. Paljon älykkäämpiä kuin SAM 3 -malli. Niillä voi segmentoida hyvin tarkasti rajattuja kuvan osia. Tätä siluettipohjainen mallinus juuri tarvitsee. Esimerkkikuvassa malli on tunnistanut, ettei neuletyö tai pöytäliina ole osa pöytää, ja segmentoinut ne pöytää peittäväksi esineiksi.
Agenttien siluetteihin pohjautuva mallinnusprosessi
Kokeilin siluettipohjaiseen mallinnusprosessiin OpenAI:n GPT-6 Astraa ja GPT-6.1 Solia. Molemmat malleista toimivat prosessin kanssa. GPT-6.1 Luna on liian tyhmä ymmärtämään nykyisiä ohjeita. Selkeämmät tai yksityiskohtaisemmat ohjeet saattaisivat saada sen toimimaan, mutta en ole vielä kokeillut sitä. Tällä hetkellä Astra toimii täydellisesti, ja 100 euroa kuukaudessa maksavan tilauksen käyttömäärä riittää minun tämänhetkiseen käyttötarpeeseen. Sen vuoksi en lähtenyt yrittämään optimoida prosessia pienemmälle mallille.
Sohvapöydän tapauksessa prosessi etenee näin: agentti näkee, että kuvissa on sohvapöytä. Se luo säädettävän 3D-mallin, joka muistuttaa kuvien pöytää. Tässä esimerkissä agentti päätyi malliin, jonka parametrit on lueteltu taulukossa 1. Ensimmäinen malli oli hieman yksinkertaisempi, mutta agentti paransi sitä optimoinnin aikana.
Taulukko 1. Optimoitavat parametrit agentin luomassa lopullisessa mallissa.
| Pöydän osa | Parametrit | Lukumäärä |
|---|---|---|
| Kokonaisuus / pöydän kansi | Pöydän korkeus, kannen paksuus, alapinnan sisennys, kulmien pyöristyssäde | 4 |
| Jalat ja niiden sijoittelu | Jalkojen etäisyys kannen reunoista, jalan yläosan leveys, jalan alaosan leveys, kapenemisen alkamiskorkeus, alaosan siirtymä, jalan syvyysmitan säätö, reunaetäisyyden säätö syvyyssuunnassa | 7 |
| Hylly | Korkeus ja paksuus | 2 |
| Kannen alla olevat kehyslistat | Korkeus ja paksuus | 2 |
| Yhteensä | 15 |
Agentilla on riittävästi tietoa oikeasta elmästä ymmärtääkseen esimerkiksi, että pöydän kaikki neljä jalkaa ovat samanlaisia. Siksi mallin kaikkilla jaloilla on yhteiset parametrit. Mallin parametrien lisäksi jokaisella kuvalla on parametrit atsimuutille, korkeuskulmalle, kameran kierrolle optisen akselin ympäri, etäisyydelle, kuvan rajauksen vaakasuuntaiselle siirtymälle, kohdepisteen korkeudelle ja polttovälille. Ne määrittävät kameran sijainnin, suunnan ja projektion. Koko näkymässä oli yhteensä 36 parametria: 15 geometrialle ja 7 kullekin kolmesta kuvasta.
Pöydän kannen mitat annettiin kehotteessa ainoina esineestä mitattuina mittoina. Mallinnustehtävän kehote oli suomennettuna seuraava (alkuperäinen kehoite oli englanniksi):
Mallinna sohvapöytä -hakemistossa oleva sohvapöytä. Käytä "cad skill" prosessia. Pöydän kansi on täsmälleen 65 cm kumpaankin suuntaan. Tavoittele kaikille kuville 98 %:n IoU-arvoa. Älä mallinna pöydällä olevaa roinaa.
Agentti segmentoi pöydän siluetin jokaisesta kuvasta kuvamallin ja edellä kuvatun menetelmän avulla.
Optimointitehtävänä on maksimoida kuvista erotettujen siluettien ja projisoidun 3D-mallin vastaavien siluettien leikkauksen ja unionin suhde (intersection over union, IoU). Agentti optimoi 3D-mallin parametreja, kameroiden sijanteja ja suuntia sekä linssin projektioparametreja iteratiivisesti. Agentti voi vapaasti valita tilanteeseen parhaiten sopivan optimointimenetelmän.
Siluetteihin perustuva optimointi ei ole konveksi optimointiongelma. Siinä on paikallisia maksimeja, jotka eivät ole globaaleja maksimeja. Tämä mutkistaa työnkulkua, mutta agentti selviää näistä ongelmista helposti. Agentti vaihtaa optimointistrategiaa, hienosäätää alkuarvoja ja päivittää mallia työn edetessä tilanteen mukaan työstäessään ongelmaa kohti parasta ratkaisua.
IoU antaa hyvän tavoitteen agentille. Agenttia voi kehoittaa parantamaan 3D-mallia, kunnes se saavuttaa tietyn IoU-arvon. Tämä antaa agentille selkeän tavoitteen ja kannustaa sitä jatkamaan, kunnes tavoite on saavutettu.
Alla oleva interaktiivinen demo näyttää sohvapöydän mallinnuksen lopputuloksen. Voit pyörittää mallia ja tarkastella sitä eri suunnista. Kun napsautat jotakin kuvista, virtuaalinen kamera asettuu vastaamaan valokuvan näkymää. Säädä kuvan läpinäkyvyyttä tai piilota/tuo näkyville kuva nopeasti, niin näet mallin ja todellisen kuvan väliset erot.
Mallinnusprosessi on kuvattu agenteille tarkoitettuna "skillinä" täällä: https://github.com/janne-alatalo/image-to-cad-skill. Projekti sisältää visualisointiohjelmiston tulosten tarkasteluun. Sitä on testattu OpenAI:n malleilla, mutta se voisi toimia millä tahansa mallilla ja agenttiympäristöllä, josta on pääsy segmentointityönkulkuun kykenevään kuvamalliin. Codex antaa agenteille automaattisesti työkalut kehotteiden lähettämiseen OpenAI:n kuvamalleille, joten Codexin kanssa "skill" toimii suoraan. Tätä artikkelia kirjoitettaessa Anthropicilla ei ole omaa kuvamallia. Anthropicin malleja käytettäessä tarvitaan ylimääräistä säätämistä, jotta agentti voi käyttää jotain ulkoista kuvamallia.
Huonekalujen järjestelysovellus mallinnuksen käyttökohteena
Kumppani ehdotti, että voisimme järjestää meidän huonekalut uusiksi. Oletettavasti minä olen se, joka lopulta raahaa niitä huonekaluja ympäriinsä, kunnes hän löytää mieleisensä järjestyksen. Aloin miettiä, miten voisin säästää vaivaa. Ajattelin "work smarter not harder" ja päätin tehdä hänelle sovelluksen, jonka avulla hän voi kokeilla eri järjestyksiä virtuaalisesti ennen kuin minun tarvitsee siirtää yhtäkään oikeaa huonekalua.
Mallinnusprosessi toimii erittäin hyvin huonekalujen mallinnukseen, koska huonekalut on yleensä helppo mallintaa muutamalla parametrilla: niissä on suoria reunoja, monilla osilla on yhteiset parametrit ja niin edelleen. Olen käyttänyt mallinnusprosessia meidän huonekaljen mallintamiseen. Kustakin huonekalusta tarvitaan vain yksi mitattu mitta, jotta kaikkien mallien mittakaava saadaan kohdalleen.
Huonekalujen lisäksi käytin kuvaa meidän asunnon pohjapiirroksesta asunnon 3D-mallinnukseen. Asunnon mallintaminen pohjapiirroksen perusteella on GPT-6 Astran kaltaiselle mallille helppo tehtävä.
Kun 3D-mallit olivat valmiit, tein nopeasti vibe-koodaamalla solvelluksen, jota kumppanini voi käyttää uuden järjestyksen suunnitteluun.
Tällä hetkellä sovelluksessa voi vain siirrellä huonekaluja, mutta kiinnostava jatkokehitys olisi lisätä mahdollisuus tuoda uusia huonekaluja kuvien perusteella. Käyttäjä voisi ladata muutaman kuvan uudesta huonekalusta, ja taustajärjestelmä käyttäisi Codexia Codex App Serverin [8]8. OpenAI. Codex app server. https://learn.chatgpt.com/docs/app-server kautta ajaakseen agenttia, jolla on pääsy tähän mallinnusprosessin "skilliin". Ajattelin, että tästä voisi olla hyötyä huonekaluostoksilla. Liikkeessä voi ottaa muutaman valokuvan ja nähdä suoraan, että miltä se näyttäisi kotona. Yksinkertaisen huonekalun mallintamiseen kuluu 10–20 minuuttia, mutta sen vielä jaksaa odottaa huonekaluliikkeessä.
Kaiken kaikkiaan projekti onnistui hyvin. On mukava löytää näille uusille tekoälymalleille uusia käyttötapoja. Vielä muutama vuosi sitten tällaiset asiat olisivat olleet mahdollisia vain scifileffoissa.
Viittaa tähän artikkeliin
APA 7 -viite suomenkieliseen versioon 1. Käytä alla olevaa pysyvää osoitetta.
Alatalo, J. (4.10.2026). Siluetteihin perustuva parametrinen 3D-mallinnus agenttien avulla. https://janne-alatalo.fi/fi/articles/silhouette-modeling/
Lähteet
1. J. Alatalo. Creating a parametric 3D model of a sewing machine motor from 20 images using GPT6-Astra. Jamk Arena Pro. 2026. https://urn.fi/urn:nbn:fi:jamk-issn-2984-0783-364 ↩1
2. Z. Wu, W. Jiang, and H. Yu. Analytical derivatives for differentiable renderer: 3D pose estimation by silhouette consistency. Journal of Visual Communication and Image Representation. 2020. vol. 73, pp. 102960. https://doi.org/10.1016/j.jvcir.2020.102960 ↩2
3. M. Worchel, R. Diaz, W. Hu, O. Schreer, I. Feldmann, and P. Eisert. Multi-View Mesh Reconstruction With Neural Deferred Shading. Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR). 2022. pp. 6187–6197. https://openaccess.thecvf.com/content/CVPR2022/html/Worchel_Multi-View_Mesh_Reconstruction_With_Neural_Deferred_Shading_CVPR_2022_paper.html ↩3
4. N. Carion, L. Gustafson, Y.-T. Hu, S. Debnath, R. Hu, D. Suris, C. Ryali, K. V. Alwala, H. Khedr, A. Huang, J. Lei, T. Ma, B. Guo, A. Kalla, M. Marks, J. Greer, M. Wang, P. Sun, R. Rädle, T. Afouras, E. Mavroudi, K. Xu, T.-H. Wu, Y. Zhou, L. Momeni, R. Hazra, S. Ding, S. Vaze, F. Porcher, F. Li, S. Li, A. Kamath, H. K. Cheng, P. Dollár, N. Ravi, K. Saenko, P. Zhang, and C. Feichtenhofer. SAM 3: Segment Anything with Concepts. 2025. https://doi.org/10.48550/arXiv.2511.16719 ↩4
5. Qwen Team. Qwen-Image 2.1. 2026. https://qwen.ai/blog?id=qwen-image-2.1 ↩5
6. S. Pedicini. GenAI image editing showdown. 2025. https://genai-showdown.specr.net/image-editing ↩6
7. OpenAI. Introducing ChatGPT Images 2.5. 2026. https://openai.com/index/introducing-chatgpt-images-2-5/ ↩7
8. OpenAI. Codex app server. https://learn.chatgpt.com/docs/app-server ↩8