Mainoskatkojen tunnistaminen TV-tallenteista EmbeddingGemma 2 -mallilla
Upotusmalleja (embedding model) käytetään usein osana RAG-järjestelmiä (retrieval augmented generation) tiedon hakemiseen ulkoisista lähteistä. EmbeddingGemma 2 on monimodaalinen upotusmalli, joka ottaa syötteenä tekstiä, videota, ääntä ja kuvia ja muuntaa ne upotusvektoreiksi modaliteettien yhteiseen upotusavaruuteen. Monimodaalisuus mahdollistaa kiinnostavia käyttökohteita myös perinteisten RAG-työnkulkujen ulkopuolella. Kokeilin mallia aputyökaluna TV-nauhotusten mainoskatkojen tunnistamiseen osana manuaalista ja agenttista prosessia.
Upotusmalleja käytetään RAG:n, eli tiedonhaulla täydennetyn generoinnin (retrieval-augmented generation, RAG) yhteydessä. RAG ei ole upotusmallien ainoa käyttökohde, mutta nykyaikainen generatiivinen tekoäly ja RAG on tuoneet ne yleiseen tietoisuuteen.
Upotusmallit muuntavat syötteen upotusvektoreiksi moniulotteiseen avaruuteen niin, että toisiinsa liittyvät asiat sijoittuvat lähelle toisiaan [1]1. R. Girdhar, A. El-Nouby, Z. Liu, M. Singh, K. V. Alwala, A. Joulin, and I. Misra. ImageBind: One Embedding Space To Bind Them All. Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR). 2023. pp. 15180–15190. https://openaccess.thecvf.com/content/CVPR2023/html/Girdhar_ImageBind_One_Embedding_Space_To_Bind_Them_All_CVPR_2023_paper.html. Tätä ominaisuutta käytetään usein RAG-järjestelmien tiedonhaussa [2]2. H. Wolff. RAG 101: Demystifying retrieval-augmented generation pipelines. 2023. https://developer.nvidia.com/blog/rag-101-demystifying-retrieval-augmented-generation-pipelines/. Perinteisessä RAG-järjestelmässä dokumentit jaetaan osiin, joista upotusmalli muodostaa vektoriesitykset. Yksi osa voi olla esimerkiksi dokumentin aliotsikon alla oleva teksti. Kun käyttäjä kysyy jotain, myös kysymyksestä muodostetaan upotusvektori samaan upotusavaruuteen. Koska upotusmalli sijoittaa toisiinsa liittyvät asiat lähelle toisiaan, kysymyksen pitäisi sijoittua lähelle niitä dokumentin osia, joista toivottavasti löytyy vastaus käyttäjän kysymykseen. Kysymyksen ja dokumentin osien vektoriesitysten samankaltaisuutta mitataan yleensä kosinisamankaltaisuudella [3]3. Wikipedia contributors. Cosine similarity. https://en.wikipedia.org/wiki/Cosine_similarity. Samankaltaisimmat osat haetaan tietokannasta ja annetaan tekoälymallille lisäkontekstiksi, jota se voi hyödyntää vastatessaan käyttäjän kysymykseen.
Monimodaliset upotusmallit tukevat myös muita syötetyyppejä tekstin lisäksi, kuten kuvia, videota ja ääntä. EmbeddingGemma 2 on yksi tällainen malli [4]4. S. Dua and H. Schechter Vera. EmbeddingGemma 2: An open, lightweight multimodal embedding model. 2026. https://blog.google/innovation-and-ai/technology/developers-tools/embeddinggemma-2/. Monimodalisuus avaa upotusmalleille kiinnostavia uusia käyttötapoja.
Kun upotusmalleja käytetään RAG:n kanssa, järjestelmä hakee usein vain tietyn määrän kaikkein samankaltaisimpia dokumentin osia. Kosinisamankaltaisuus on yksi numero, joka kertoo, kuinka samansuuntaisia kaksi vektoria ovat moniulotteisessa upotusavaruudessa. Samansuuntaiset vektorit saavat suuria kosinisamankaltaisuuden arvoja, kun taas hyvin eri suuntiin osoittavat vektorit saavat pieniä arvoja. Vektorit tallennetaan yleensä vektoritietokantaan, josta käyttäjän kysymyksen upotusvektoria lähinnä olevat dokumenttien osat löytyvät tehokkaasti.
Myös video kannattaa jakaa lyhyisiin pätkiin samaan tapaan kuin dokumentit jaetaan pienempiin osiin. Videoiden pätkistä muodostetaan upotusvektorit upotusavaruuteen, minkä jälkeen voidaan etsiä annettua hakua parhaiten vastaavat pätkät. Videopätkien upotusvektoreita voi käyttää samalla tavalla kuin dokumentin osien upotusvektoreita perinteisessä RAG-järjestelmässä: etsitään käyttäjän hakua parhaiten vastaavat pätkät. Videon tapauksessa on kuitenkin myös muita mahdollisuuksia hyödyntää samankaltaisuusdataa. Video on aikasarjadataa, ja pätkillä on toistojärjestys. Pätkien samankaltaisuudesta käyttäjän hakuun voi piirtää viivakaavion koko videon ajalta. Näin saadaan hyödyllinen visuaalinen signaali siitä, missä kohtaa aikajanaa videon sisältö vastaa parhaiten käyttäjän hakua.
Seuraava demo näyttää tämän käytännössä. Demo käyttää Big Buck Bunny -lyhytelokuvaa [5]5. Blender Foundation. Big Buck Bunny. https://peach.blender.org/, joka on julkaistu Creative Commons Nimeä 3.0 -lisenssillä [6]6. Blender Foundation. About Big Buck Bunny: License. https://peach.blender.org/about/. Elokuva on jaettu viiden sekunnin pätkiin 2,5 sekunnin päällekkäisyydellä. Kuvataajuutena on kaksi ruutua sekunnissa. Pätkistä muodostetaan upotusvektorit EmbeddingGemma 2 -mallilla. Niiden ja seuraavien tekstikehotteiden upotusvektorien välille lasketaan kosinisamankaltaisuus. Tekstikehoitteet ovat: ”A large white rabbit” (suuri valkoinen kani), ”Scrolling end credits” (rullaavat lopputekstit) ja ”A butterfly flying” (lentävä perhonen). Demo näyttää samankaltaisuusarvot alareunan viivakaaviossa, josta näkee selvästi, missä kohtaa elokuvaa kehotteiden kuvaamat asiat esiintyvät. Kaavion alapuolella on myös lista parhaiten vastaavista pätkistä kullekkin kehoitteelle.
Kuten demosta näkee, kehotteet ”A large white rabbit” ja ”Scrolling end credits” toimivat todella hyvin. Myös ”A butterfly flying” näkyy signaalissa, mutta kehotteen ja videopätkien vastaavuus ei ole aivan yhtä selvä. Parhaiten vastaavassa pätkässä näkyy vain perhosen siipiä. Toiseksi parhaiten vastaavassa pätkässä perhonen vain räpyttelee siipiään eikä lennä. Kolmanneksi parhaiten vastaavassa pätkässä on liito-orava eikä perhonen. Näyttää siltä, että ”lentäminen” tekee tästä pätkästä samankaltaisen kehotteen kanssa.
Nämä virhetilanteet ovat kiinnostavia. Ne osoittavat, että upotusavaruus on hyvin abstrakti eikä aina toimi niin kuin odottaisi. Kun haettava asia on selkeä ja erottuva, samankaltaisuuden mittaaminen toimii paremmin.
Mainoskatkojen tunnistaminen
Taustaa sille, miksi haluan tunnistaa mainoskatkot: menen iltaisin aikaisin nukkumaan. Olen nähnyt monesta elokuvasta pelkästään ensimmäisen tunnin, koska minun nukkumaanmenoaika tulee yleensä vastaan noin tunti elokuvan alkamisen jälkeen. Ongelman ratkaisemiseksi toteutin oman TV-tallennusohjelmiston. Se oli yksi ensimmäisistä projekteistani sen jälkeen, kun agenttien koodauskyvyt kehittyivät niin hyviksi, että hyödyllisten ohjelmistojen luominen niiden avulla oli helppoa. Projekti on ollut minun todo-listalla vuosia, ja olin miettinyt jo arkkitehtuurinkin valmiiksi päässäni, mutta minulla ei koskaan ollut aikaa tai energiaa koodata sitä käsin. Ohjelmisto toimii todella hyvin! Se sisältää täsmälleen ne ominaisuudet, jotka minä tarvitsen... paitsi: mainoskatkojen automaattinen ohittaminen olisi mukava lisä.
Mainoskatkojen tunnistamiseen on jo olemassa ohjelmistoja, kuten Comskip [7]7. erikkaashoek. Comskip. https://github.com/erikkaashoek/Comskip. Se tunnistaa mainokset heuristisilla säännöillä. Menetelmä on yksinkertainen, mutta kokemukseni mukaan heuristiikat menevät jossain kohtaa rikki eivätkä toimi kuten pitäisi. Mainoskatkojen automaattinen ohittaminen sen tunnistusten perusteella saattaisi toimia 99 prosenttia ajasta, mutta sen viimeisen prosentin kohdalla järjestelmä todennäköisesti skippaisi jotain tärkeää joka ei ole hyvä asia. Käyttäisin paljon mieluummin työkalua, jossa on mukana oikeaa älyä ja joka toimii 100 prosenttia ajasta. Nykyaikainen generatiivinen tekoäly ja agentit ehkä tekevät tästä mahdollista.
Tein joitakin alustavia kokeiluja agenteilla. Niissä agentti kävi koko tallenteen läpi matalalla kuvataajuudella ja merkitsi mahdolliset mainokset. Sen jälkeen se etsi tarkat alku- ja loppukohdat poimimalla ruutuja tiheämmin mahdollisten mainosten alkamisen ja loppumisen ympäriltä. Menetelmä toimi, mutta se kulutti paljon tokeneita. Ajattelin, että jos voisin antaa mallille karkeat arviot mainoskatkojen sijainneista, niin se voisi tarkistaa vain ne kohdat. Tämä tekisi menetelmästä paljon tehokkaamman.
Näin EmbeddingGemma 2 -mallin julkaisusta kertovan blogin ja siihen liittyvät demot [4]4. S. Dua and H. Schechter Vera. EmbeddingGemma 2: An open, lightweight multimodal embedding model. 2026. https://blog.google/innovation-and-ai/technology/developers-tools/embeddinggemma-2/. Upotusmalli näytti toimivan todella hyvin eri syötetyyppien välillä. Siitä sain ajatuksen, että se voisi antaa karkeat arviot mainoskatkojen sijainneista ja tehostaa menetelmää.
Tein nopean kokeilun mainoskanavalta tallennetulla Päiväni murmelina -elokuvalla (Groundhog Day). Muodostin mallilla videosta upotusvektorit kymmenen sekunnin pätkissä ja laskin jokaisen pätkän kosinisamankaltaisuuden tekstin ”tv commercial” upotusvektorin kanssa. Tulos oli todella lupaava. Jo tämä yksinkertainen ensimmäinen testi antoi selviä vihjeitä siitä, missä mainokset olivat. GPT-6 Astra -mallin avustuksella kehitimme kehotteen muotoon: ”a short promotional video with fast cuts, product close-ups, animated graphics, slogans and brand logos”. Käännettynä syöte kuvaa lyhyttä mainosvideota, jossa on nopeita leikkauksia, lähikuvia tuotteista, animoitua grafiikkaa, iskulauseita ja tuotemerkkien logoja. Tällä kehotteella signaalista tuli paljon selkeämpi. Mainokset näkyvät signaalissa selvinä huippuina, kuten kuvasta 1 näkee.
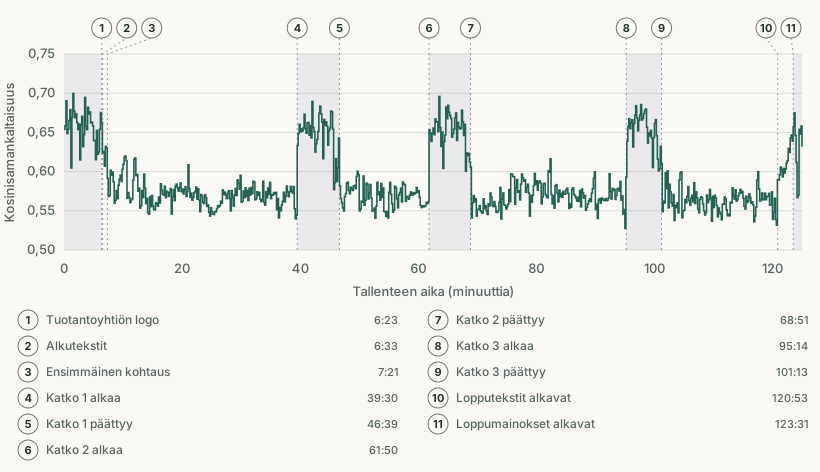
Signaalin avulla mainosten ohittaminen on jo helppoa käsin. Olisi kuitenkin hienoa, jos järjestelmä ohittaisi mainokset automaattisesti. Se kuitenkin vaatii, että jokaisen mainoskatkon alku- ja loppukohdan on tunnistettu hyvin tarkasti.
Agenttien avustama mainosten tunnistus
Kokeilin agenttista mainosten tunnistusta räätälöidyssä agenttien ajoympäristössä OpenAI:n GPT-6 Luna-, GPT-6.1 Sol- ja GPT-6 Astra -malleilla sekä omassa ympäristössä ajettavalla Qwen3.8-27B-mallilla, jossa oli neljän bitin kvantisointi.
Omassa ympäristössä ajetun Qwen3.8-27B-mallin tarkka versio on Qwen3.8-27B-UD-Q4_K_XL.gguf [8]8. Unsloth AI. Qwen3.8-27B-GGUF. https://huggingface.co/unsloth/Qwen3.8-27B-GGUF. Mallia ajettiin minun pelikoneellani, jossa on NVIDIA GeForce RTX 4090 -näytönohjain ja AMD Ryzen 7 7800X3D -prosessori. Mallin ajamiseen käytettiin llama.cpp-inferenssimoottoria, 125 184 tokenin konteksti-ikkunaa ja Q8-kvantisoitua KV-välimuistia. Ensimmäisten 17 attention-lohkon feed-forward-kerrokset siirrettiin ajettaviksi prosessorilla, jotta haluttu konteksti-ikkuna oli mahdollinen (llama.cpp-argumentti: -ot 'blk\.([0-9]|1[0-6])\.ffn_(down|gate|up)\.weight=CPU').
Räätälöity ajoympäristö käyttää OpenAI:n malleille Codexia Codex App Serverin [9]9. OpenAI. Codex app server. https://learn.chatgpt.com/docs/app-server kautta ja omassa ympäristössä ajettavalle mallille Pi:tä Pi RPC:n [10]10. Earendil Works. RPC mode (Version 1.1.0). 2026. https://github.com/earendil-works/pi/blob/abe508e1b89912adde45528136c3221eb69acdd7/packages/coding-agent/docs/rpc.md kautta. Agenteille annettiin kuvaaja, joka näyttää jokaisen kymmenen sekunnin pätkän samankaltaisuuden mainosten visuaalista sisältöä kuvaavan kehotteen kanssa, sekä työkalut kuvaajan käsittelyyn ja tulosten raportoimiseen. Taulukossa 1 on listattu agenteille annetut työkalut.
Taulukko 1. Agenteille annetut työkalut.
| Työkalu | Kuvaus |
|---|---|
| view_graph(start, end) | Näytä samankaltaisuussignaalin kuvaaja halutulta aikaväliltä tai zoomaa siihen. |
| get_frames(times) | Hae videoruutuja pyydetyistä aikakohdista. Mukana tulevat ruutujen tunnisteet ja tarkat aikaleimat. |
| add_signal(text=… or reference_seconds=…) | Lisää samankaltaisuuskäyrä uuden tekstin upotusvektorin ja videopätkän upotusvektoreiden avulla. |
| set_visible_signals(ids) | Valitse näkyvissä olevat käyrät. |
| report_boundary(...) | Ilmoita mainoskatkon alku- tai loppukohta heti. Liitä mukaan epävarmuus, havaintoa tukevat ruudut sekä tieto siitä, onko tulos alustava vai vahvistettu. |
| revise_boundary(...) | Tarkenna tai peru aiemmin ilmoitettu rajakohta niin, että sen historia säilyy. |
| finish(notes) | Ilmoita tehtävä tehdyksi ja kuvaa jäljelle jäänyt epävarmuus tai tarkastelun kattavuus. |
Ajoympäristön toteutti GPT-6 Astra, joka kirjoitti myös agenteille annetun kehotteen. Kehote oli alun perin englanniksi. Tässä se on suomennettuna:
Analysoit televisiotallennetta löytääksesi ohjelman ulkopuoliset mainoskatkot. Käytä annettua samankaltaisuuskuvaajaa silmämääräisen tarkastelun kohdentamiseen. Suurempi kosinisamankaltaisuus tarkoittaa parempaa vastaavuutta käyrän hakutekstiin tai vertailukohteeseen; se ei ole mainosluokitus. Lähennä kuvaajaa, lisää uusia tekstiin tai vertailupätkiin perustuvia samankaltaisuussignaaleja ja näytä tai piilota käyriä tarpeen mukaan. Ota huomioon signaalin näkyvät muutokset, myös pitkään jatkuvat alueet ja aiemman päätelmän kanssa ristiriidassa olevat muutokset. Automaattisia ehdokkaita ei ole.

Etsi kaikki ohjelman ulkopuoliset katkot tarkasti ja tarkastele samalla mahdollisimman vähän videoruutuja. Ilmoita jokainen todennäköinen alku- tai loppukohta report_boundary-työkalulla heti, kun sinulla on sitä tukevaa näyttöä. Älä odota, että koko tallenne on analysoitu. Katkon alkukohdan voi ilmoittaa ennen kuin loppukohta on tiedossa. Anna katkolle pysyvä break_id. Ilmoita tarvittaessa ensin likimääräiset rajakohdat ja tarkenna tai peru ne sitten revise_boundary-työkalulla. Tarkkuus on tärkeämpää kuin muutaman ruudun säästäminen.

Mainokset, muiden elokuvien tai ohjelmien trailerit, sponsoritunnisteet ja kanavatunnukset eivät kuulu ohjelmaan. Elokuvan tuotantoyhtiöiden logot ja tarinan sisäiset mainokset kuuluvat ohjelmaan. Elokuvalta näyttävä sisältö voi olla jonkin muun elokuvan traileri: varmista kohdeohjelman tunnistettavuus ja jatkuvuus kohdissa, joissa siihen näyttää palattavan. Kuvaajan hetkellinen lasku ei ratkaise sitä, mitä korkean samankaltaisuuden alueen loppuosa sisältää.

Rajakohdan aika on uuden tilan ensimmäisen lähderuudun aika: alkukohta kuuluu katkoon, loppukohta ei. Käytä palautettuja ruututunnisteita ja PTS-aikaleimoja. Ilmoita rajakohta ruuduntarkaksi vain, jos olet tarkastellut rajakohdan välittömästi vierekkäiset ruudut ennen muutosta ja sen jälkeen. Säilytä muuten epävarmuusväli. Säilytä elokuvan alussa tai siihen palattaessa näkyvä häivytys; epäselville mustille ruuduille on ilmoitettava käsittelyperiaate. Tallenteen alussa tai lopussa olevat osittaiset katkot voivat ulottua tallenteen reunoihin.

Käytä vain kokeessa annettuja työkaluja. Käytettävissä ei ole komentotulkkia, tiedostojärjestelmän tarkastelua, verkkohakua, delegointia eikä aiempia tuloksia. Älä yritä päätellä piilotettuja vertailumerkintöjä. Älä käy koko tallennetta kattavasti läpi tasavälein poimituilla ruuduilla. Jokainen palautettu lähderuutu lasketaan mukaan, myös uudelleen haetut ruudut; kuvaajakuvat lasketaan erikseen. Kutsu finish-työkalua, kun olet valmis, ja kuvaa ratkaisemattomat alueet sekä puutteet tarkastelun kattavuudessa.
Ajoympäristö tallensi kaikki agenttien tekemät työkalukutsut jonka pohjalta seuraava animaatio on tehty. Animaatio näyttää, miten mallit suoriutuivat tehtävästä.
GPT-6.1 Sol ja GPT-6 Astra tunnistivat mainoskatkojen ajankohdat alle sekunnin virheellä käsin tarkastettuihin aikoihin verrattuna. GPT-6 Luna ja Qwen tyrivät tehtävän medium-ajattelutasolla (oletusarvo), mutta molempien tulokset paranivat paljon xhigh-ajattelutasolla. Qwen venyttää silti kolmannen mainoskatkon loppua muutamalla sekunnilla yli mainoskatkon lopun vielä xhigh-asetuksellakin. Muuten molempien mallien tulokset ovat xhigh-ajattelutasolla täysin käyttökelpoisia.
Kiinnostavaa kyllä, add_signal-työkalua käytettiin vain kahdessa ajossa. Sen avulla agentti voi lisätä kuvaajaan uuden tekstikehotteen samankaltaisuussignaalin. Tästä voi olla apua, jos oletussignaali on liian heikko. Uuden signaalin lisääminen on melko halpaa, koska videopätkien upotusvektorit on jo laskettu. Vain uudesta tekstikehotteesta täytyy muodostaa upotusvektori ja verrata sitä pätkien olemassa oleviin upotusvektoreihin. Tämän tallenteen kohdalla oletussignaali näyttää olleen useimmille malleille riittävän vahva, joten ne eivät vaivautuneet lisäämään toista signaalia.
Menetelmän käyttö käytännössä
EmbeddingGemma 2 on melko pieni malli. Siinä on 740 miljoonaa parametria, paljon vähemmän kuin nykyaikaisissa suurissa kielimalleissa. Vertailun vuoksi pelikoneellani ajettavassa Qwen3.8-27B-mallissa on 27 miljardia parametria. Tämän ”pienen” koon ansiosta mallia voi ajaa prosessorilla ihan kohtuullisella nopeudella. Kolmituntisen tallenteen upotusvektorien laskeminen ei silti ole prosessorilla nopeaa. Testeissäni se olisi kestänyt noin kymmenen tuntia palvelimellani, jossa on Intel Xeon E3-1275 v6 -prosessori, kun prosessi oli rajattu kahdelle fyysiselle ytimelle. Palvelimella pyörii muitakin palveluja, joten en halunnut antaa kaikkia ytimiä tälle työlle. Vertailun vuoksi RTX 4090 -näytönohjaimeni laski samojen pätkien upotusvektorit seitsemässä minuutissa.
Kymmenen tuntia on silti hyväksyttävä aika tällaisessa käyttötapauksessa. Tallennan yleensä jotain illalla ja katson sen todennäköisesti aikaisintaan seuraavana päivänä. Palvelimella on siinä välissä hyvin aikaa prosessoida tallenne. Lisäksi kymmenen tunnin arvio koskee kokonaisen kolmituntisen tallenteen kaikkien pätkien upotusvektorien laskemista. Yksinkertaisten tekstikehotteiden käsittely on paljon nopeampaa: lyhyen lauseen upotusvektorin laskeminen kestää noin 100 millisekuntia.
Mahdollisuus muodostaa uusista kehotteista nopeasti upotusvektoreita ja verrata niitä videopätkien olemassa oleviin upotusvektoreihin mahdollistaa käyttäjälle mielenkiintoisia ominaisuuksia. Esimerkkinä Päiväni murmelina -tallenne. Elokuvassa päähenkilö elää aikasilmukassa ja herää aina samaan päivään uudelleen ja uudelleen. Jokainen kierros alkaa siitä, että hän herää sängyssä. Jos laskemme tallenteen pätkien ja kehotteen ”person waking up from bed” eli sängystä heräävän ihmisen upotusvektorien välisen samankaltaisuuden, saamme kuvassa 2 näkyvän kuvaajan.
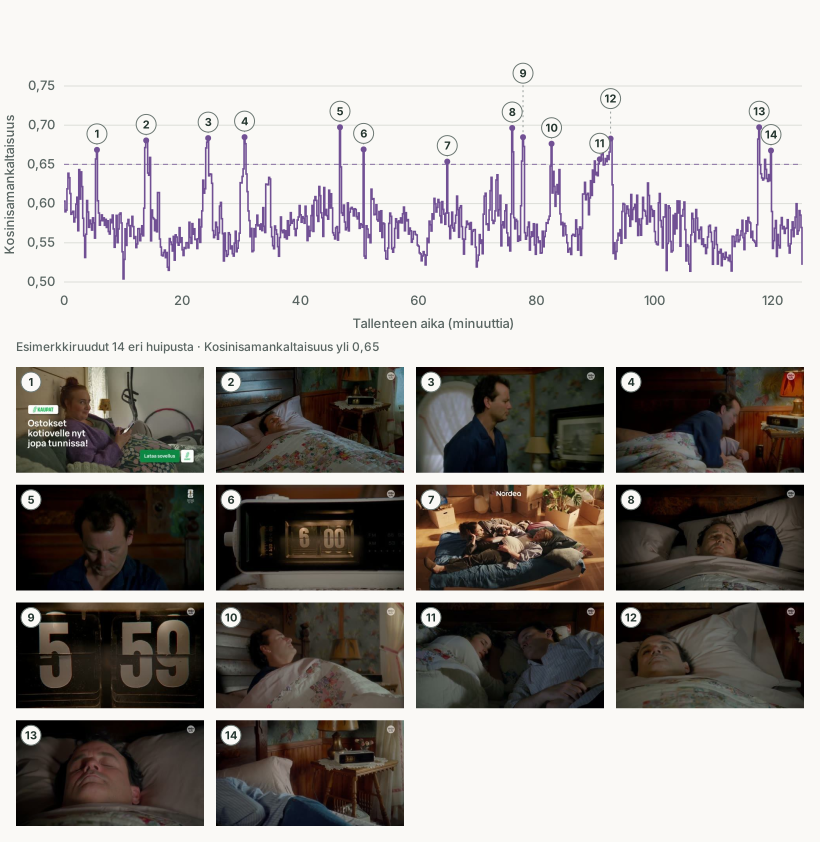
Kiinnostavaa kyllä, kuvaaja näyttää melko hyvin, missä kohtaa kukin kierros alkaa elokuvassa. Tämä on toinen syy käyttää upotusmallia mainoskatkojen tunnistamiseen: samat videon upotusvektorit voivat auttaa käyttäjää löytämään kohtauksia kuvailemalla, mitä hän haluaa nähdä.
Kaiken kaikkiaan kokeilu onnistui todella hyvin, ja siitä sain muutaman idean upotusmallien muihin käyttötapauksiin. Yksi mahdollinen käyttötapaus on tiedonsiirtokaistan säästäminen silloin, kun laskentatehoa on reilusti käytettävissä, mutta tiedonsiirtokaista on rajattua. Toinen käyttötapaus on antaa agentin kuvailla, mitä suorasta videostriimistä pitäisi tarkkailla, ja herättää agentti sitten, kun kuvauksen mukaista sisältöä ilmestyy näkyviin. Nämä kokeilut jäävät kuitenkin toiseen kertaan.
Viittaa tähän artikkeliin
APA 7 -viite suomenkieliseen versioon 1. Käytä alla olevaa pysyvää osoitetta.
Alatalo, J. (17.10.2026). Mainoskatkojen tunnistaminen TV-tallenteista EmbeddingGemma 2 -mallilla. https://janne-alatalo.fi/fi/articles/embedding-ad-detection/
Lähteet
1. R. Girdhar, A. El-Nouby, Z. Liu, M. Singh, K. V. Alwala, A. Joulin, and I. Misra. ImageBind: One Embedding Space To Bind Them All. Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR). 2023. pp. 15180–15190. https://openaccess.thecvf.com/content/CVPR2023/html/Girdhar_ImageBind_One_Embedding_Space_To_Bind_Them_All_CVPR_2023_paper.html ↩1
2. H. Wolff. RAG 101: Demystifying retrieval-augmented generation pipelines. 2023. https://developer.nvidia.com/blog/rag-101-demystifying-retrieval-augmented-generation-pipelines/ ↩2
3. Wikipedia contributors. Cosine similarity. https://en.wikipedia.org/wiki/Cosine_similarity ↩3
4. S. Dua and H. Schechter Vera. EmbeddingGemma 2: An open, lightweight multimodal embedding model. 2026. https://blog.google/innovation-and-ai/technology/developers-tools/embeddinggemma-2/ ↩4↩8
5. Blender Foundation. Big Buck Bunny. https://peach.blender.org/ ↩5
6. Blender Foundation. About Big Buck Bunny: License. https://peach.blender.org/about/ ↩6
7. erikkaashoek. Comskip. https://github.com/erikkaashoek/Comskip ↩7
8. Unsloth AI. Qwen3.8-27B-GGUF. https://huggingface.co/unsloth/Qwen3.8-27B-GGUF ↩9
9. OpenAI. Codex app server. https://learn.chatgpt.com/docs/app-server ↩10
10. Earendil Works. RPC mode (Version 1.1.0). 2026. https://github.com/earendil-works/pi/blob/abe508e1b89912adde45528136c3221eb69acdd7/packages/coding-agent/docs/rpc.md ↩11